 正版资源
AI驱动的音色调制合成器插件 DataMind Audio Concatenator v1.1.9 Win
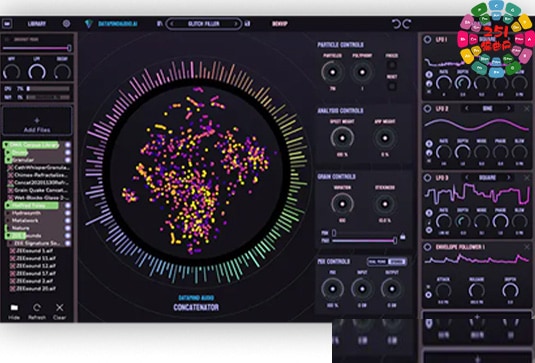
DataMind Audio Concatenator v1.1.9(Win)是一款 AI 驱动的音频拼接合成器插件。它的用途很明确:把麦克风、乐器或音频文件作为实时输入,再用你采样库中其他声音的片段重新构建信号,让原本静态的声音库变成可演奏的乐器。对于做电子音乐、声音设计和配乐的人来说,它更像一个
网盘链接 · 支付成功后自动发货
永久有效 · 链接失效免费补发
每日 9:00-21:00 在线客服
DataMind Audio Concatenator v1.1.9(Win)是一款 AI 驱动的音频拼接合成器插件。它的用途很明确:把麦克风、乐器或音频文件作为实时输入,再用你采样库中其他声音的片段重新构建信号,让原本静态的声音库变成可演奏的乐器。对于做电子音乐、声音设计和配乐的人来说,它更像一个“实时素材重组器”,而不是传统采样器。
实时输入如何驱动语料库拼接
Concatenator 的核心不是播放预设,而是分析输入。插件用专有的机器学习技术实时分析现场声音,再根据输入信号的频谱与振幅成分,从语料库中选取片段进行拼接。这样一来,演奏的力度、音色变化和动态走向都会影响最终听到的结果,适合生成拟音、质感层和复杂节奏。实际放进工程时,建议先准备一套风格统一的采样库:素材之间的音色差异越小,拼接结果越容易控制;差异越大,则更容易得到不可预测的声音。语料库加载速度很快,可加载的采样数量主要取决于电脑内存。机器学习控制部分可以调节音频匹配算法对输入信号频谱和振幅成分的“权重分配”,这决定了输出是更贴近原始输入,还是更偏向语料库中的素材。
调制段:5 个 LFO、5 个包络跟随器与 5 个侧链 MIDI 包络
插件提供 5 个低频振荡器、5 个包络跟随器和 5 个支持侧链的 MIDI 包络,用来做灵活调制。包络跟随器适合让输入信号的动态去塑造拼接密度或音色走向;低频振荡器适合给持续音色加入缓慢漂移,避免分层质感过于静止;支持侧链的 MIDI 包络则方便把外部节奏或段落变化引入调制。对于工期紧的声音设计任务,这套调制可以快速做出动态拟音和层次丰富的质感;对于偏实验的电子音乐,它也能把任意音频素材重新混合成不断演变的节奏。需要注意,实时输入与语料库拼接的工作流会改变你对“演奏”的预期:先确定输入源和监听方式,再整理语料库,最后用调制段控制变化幅度,通常比一上来堆满调制更有效。

MOCHA | 01 December 2025 |
Concatenator 是一款由人工智能驱动的音频拼接插件,它能以任意麦克风、乐器或音频文件作为实时输入,瞬间将任何声音库转化为可演奏的乐器。该插件采用专有机器学习技术,实时分析现场声音输入,随后利用你的采样库中其他声音的片段重新构建音频信号。
对于专业声音设计师和创意音乐制作人而言,Concatenator 提供了一种快速高效的方式来生成复杂且不断变化的声音 —— 同时也是一款开放式创意工具,助力探索全新的声音可能性。
高效完成工作……
无论你是工期紧迫的声音设计师,还是追求特定氛围的音乐人,Concatenator 都能让你快速高效地打造复杂的分层音效。只需借助你自己的采样库,就能即时生成动态拟音、丰富质感与复杂节奏。这款工具能帮你更快完成工作,让你专注于关键的创意决策。
或是沉浸于创作乐趣……
当你想要深入探索时,Concatenator 会为你打开一个无限的创作天地。将你的声音库塑造成无数组合,把任意音频素材重新混合为动态演变的节奏,或是构建出以往需要耗费大量时间手动迭加才能实现的无限渐变质感。无论你是寻求新鲜灵感的制作人,还是塑造全新声音世界的声音设计师,Concatenator 都鼓励你大胆实验,并为你的好奇心带来回报。
核心功能一览
通过 5 个低频振荡器(LFO)、5 个包络跟随器和 5 个支持侧链的 MIDI 包络实现灵活调制
✓ 语料库采样加载速度极快。你的电脑内存容量是决定 Concatenator 可加载采样数量的唯一限制!
✓ 机器学习控制:调节音频匹配算法对输入信号的频谱和振幅成分的 “权重分配”。
✓ 粒子数量 + 复音数:动态控制精度与发声数。
✓ 概率控制:通过 “变奏(Variation)” 控制采样重复,利用 “粒子重置(Particle Reset)” 重新分散所选切片的概率,再通过 “粘性(Stickiness)” 调节采样被选中后持续发声的概率。
✓ 两种立体声模式:“立体声链接(Stereo Link)” 将保留嵌入的立体声像,或为超宽双单声道加倍发声数。
✓ 动态预设:预设可适用于任意采样组合,此外语料库预设(Corpus Presets)还会存储当前加载的采样。
同类资源
与当前资源同分类推荐 合成器
Vocaloid5软件+汉化+声源
永久有效 · 网盘发货
 合成器
功能强大的采样器和合成器 – Tracktion Collective 1.2.2 WIN
永久有效 · 网盘发货
 合成器
采样合成器 – Sample Fuel PAD MOTION v2.01 (HALion)
永久有效 · 网盘发货
 合成器
SerumFX效果器 – Xfer Records SerumFX v1.2.1b4 v1.2.1b5 UPDATE WiN MacOSX
永久有效 · 网盘发货
 合成器
NI新旗舰合成器 – Native Instruments Massive X 1.3.0 Win
永久有效 · 网盘发货